SEO 基础:抓取、索引与排名的工作方式
这一篇先检查ClearCopy的一张公开页面:网址能否被访问,HTML里有没有具体内容,搜索引擎是否有机会处理它。最后你会得到一份已填的本地检查结果,以及上线后在Search Console里查同一网址的方法。暂不猜它能排第几,也不用购买所谓“保证收录”服务。
本书的练习页在本机返回200,源码里有标题和输入说明,匿名访问不需要登录。这能说明页面存在并返回内容;它没有公网地址,也没有任何Google索引或排名结果。接下来把这些状态逐项连起来,你就知道上线后该查哪一步。
把三个过程放到ClearCopy身上
Google先发现网址并抓取内容,再处理内容决定是否进入索引;有人搜索时,再从索引中选择结果展示。对ClearCopy来说,可以分别问:
| 过程 | 对应的具体问题 | 可以实际查看的位置 |
|---|---|---|
| 抓取 | Google能否拿到公开/check页面? | HTTP响应、抓取限制、站内链接 |
| 索引 | 这张页面是否被Google处理并选入索引? | Search Console的URL检查 |
| 展示与排名 | 搜某个问题时是否展示这页? | 搜索效果报告中的查询与页面 |
Google的搜索工作方式说明把这些过程分开介绍。它们各自会发生失败或等待,所以“在我电脑上能打开”只回答了非常早的一部分。你也无需因为新页当天没有搜索访问,就立刻重写所有文章。
先从普通访问者能拿到什么开始
启动第三章的生产练习服务,在浏览器新窗口打开http://127.0.0.1:4301/check。应能看到ClearCopy标题、两个文本框和示例说明,无需账号。然后在终端运行:
curl -I http://127.0.0.1:4301/check
curl -sS http://127.0.0.1:4301/check > check-page.html
第一条看响应状态,第二条把HTML存成文件。用编辑器打开check-page.html,搜索ClearCopy local demo与English draft。本书实际读取的响应为200,HTML里能找到这些文字;它们由Astro构建到页面里,不必等点击按钮后才出现。
这就是第一次完成的检查结果:
检查位置:本地生产启动服务 /check
响应:200
标题:ClearCopy local demo
HTML中的主要内容:英文原稿标签、功能事实标签、演示说明
登录前提:无
Google索引状态:未检查;本机地址不对公网开放
当你部署自己的站点后,把命令里的本地地址换成实际HTTPS地址,再跑一遍。若返回401或登录页,普通爬虫也可能无法拿到你希望公开的内容;若返回404,先修路由,不用先研究关键词密度。若状态200但文件里只有空壳脚本,继续检查主要内容怎样渲染出来。
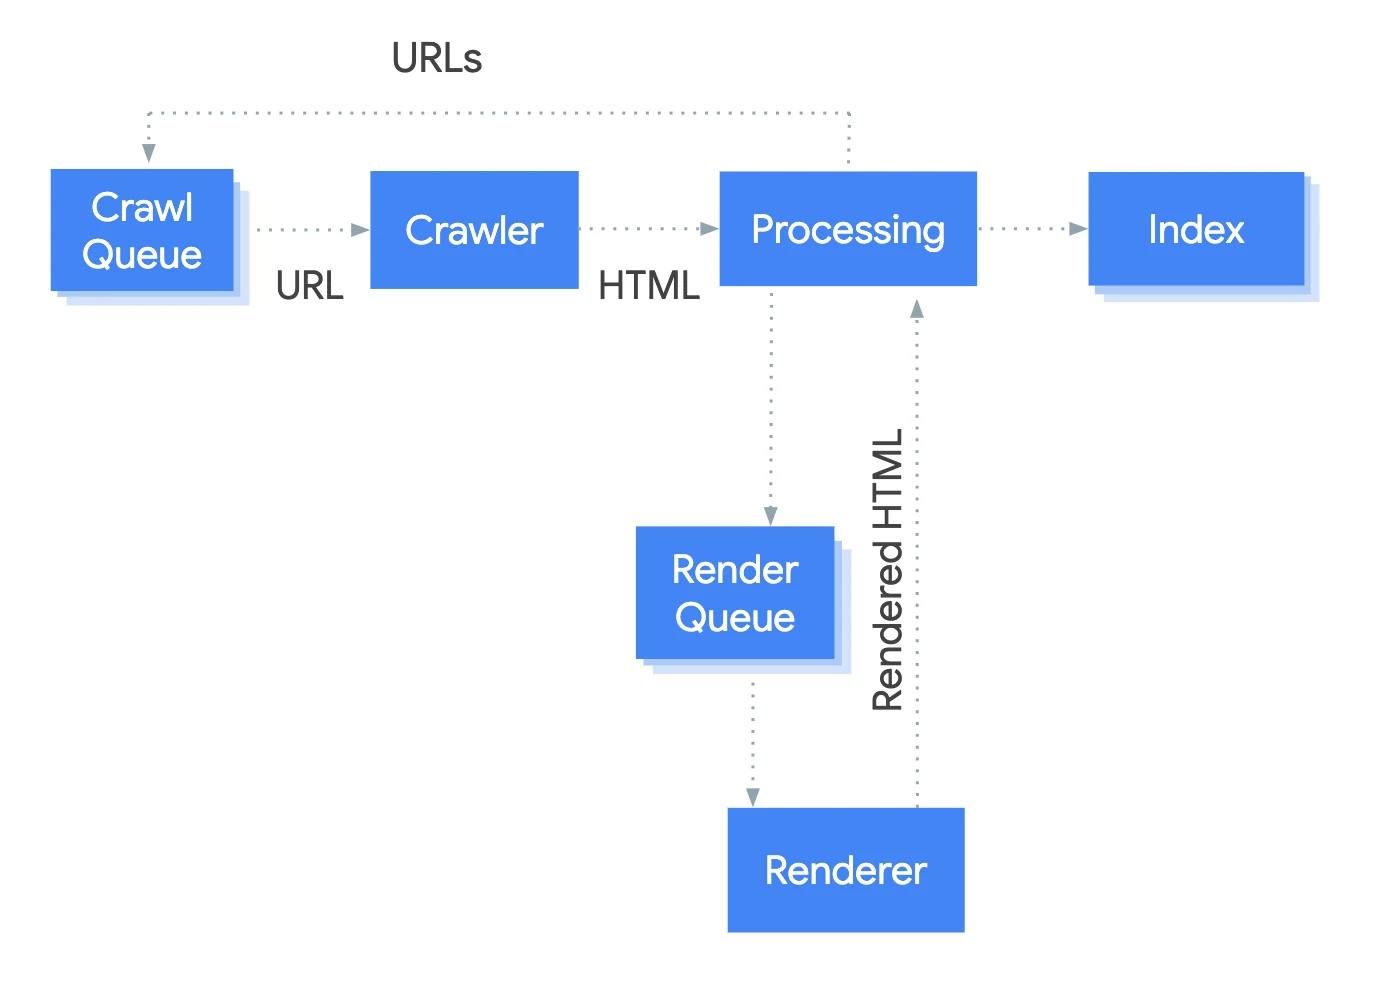
沿官方图看,为什么JavaScript会多出一个处理环节
配图来自Google JavaScript SEO指南。从抓取队列与Crawler往后看,还能看到处理、渲染与索引的环节。图要解释的是内容经过哪些步骤,不能从箭头长短推断“几小时一定收录”。
ClearCopy的标题、任务说明、示范文章可以在构建时生成HTML,访问者和爬虫都能直接读。点击检查后的私人输入与生成结果,则是交互功能,不应该为了SEO公开成无数带原稿的页面。你优化的是有用的公开入口,不是把每次用户提交都变成可搜索内容。
本书选择Astro静态生成这些公开说明,原因很直接:页面源码中就有正文,排错时可用刚才的文件核对。它不保证排名,也不要求你专门为Google返回另一版内容;浏览器与搜索引擎应该读到一致的公开信息。
上线后,用同一条URL问Google看到了什么
先在Search Console为自己的站点完成所有权验证。工具需要账号及对应站点权限,不能直接检查别人的后台记录。平台临时域名与自有域名选择的验证方式可能不同,按当前页面可用方式完成,不擅自修改不属于自己的DNS。
进入相应资源后,把完整https://你的实际域名/check粘贴到顶部URL检查栏。根据URL检查说明,先看到的是Google已索引版本的信息,也可以运行实时测试检查当前可访问性。两者时间不同:昨天抓到的旧页与今天实时返回的新页,需要分开读。
操作时优先看三项:是否允许抓取,是否允许索引,Google处理的是哪个网址。如果实时测试发现抓取失败,就按错误修访问;若实时可访问但还没索引,确认页面确有完整内容和可发现链接,再等待处理。需要时可以请求索引,但反复提交同一未修复页面不会替你补正文。
你的公开记录应写成实际看到的状态。例如“实时测试可访问,索引版本尚未显示”,而非把它缩成“SEO通过”。本文没有登录任何Search Console站点,也没有替ClearCopy提交索引请求。
让公开入口与私人内容各归其位
Google技术要求列出了基本资格:Googlebot可访问、页面成功工作、具有可索引内容。这些是进入处理流程的前提,并非收录承诺。首版可以先让首页、检查工具说明和一篇完整示范文章满足这些要求。
订单页、私人历史和账户资料靠登录与权限保护;不要拿robots.txt当作隐私锁。搜索优化时发现私人页被挡住,先问它原本是否应该公开,不要为追求“所有页面都收录”解除权限。公开教程与匿名工具可以帮助别人理解产品,用户自己的原稿没有必要成为搜索入口。
保存本篇的检查结果后,给真正公开的每张入口留一行:网址、返回状态、HTML里能找到的主要内容、索引状态与检查时间。数量不必多,两三张页面已经够开始。你现在能先把技术问题定位到访问、内容或处理状态,再去下一节规划应当写哪一页,而不用把“还没排名”当成一个无从下手的故障。