自动化运营:客服、内容、通知与日常维护
每次报告完成都手工发一封邮件,很快会占满碎片时间。本篇把这一步做成可重复执行的通知任务,并故意模拟“邮件已经发出,但程序以为失败”的情形。你会在本地看到两次尝试仍只产生一封模拟邮件,不会联系真实收件人。
准备Node.js 22和一个新的教学目录。前文的邮件正文继续使用,本节关注的是任务什么时候发、失败后怎样继续,不需要重新注册另一家邮件平台。
先确定值得自动化的这一件事
Google SRE减少重复运维劳动讨论反复、可自动化、随服务量增加的工作。用ClearCopy做一个简单选择:
| 工作 | 每次要判断什么 | 本次处理 |
|---|---|---|
| 报告已保存后发通知 | 固定收件人、报告ID和模板 | 自动排入任务 |
| 用户问缺少某项功能 | 需理解问题和产品情况 | 先人工答复 |
| 退款争议 | 需核对订单与原因 | 人工确认后处理 |
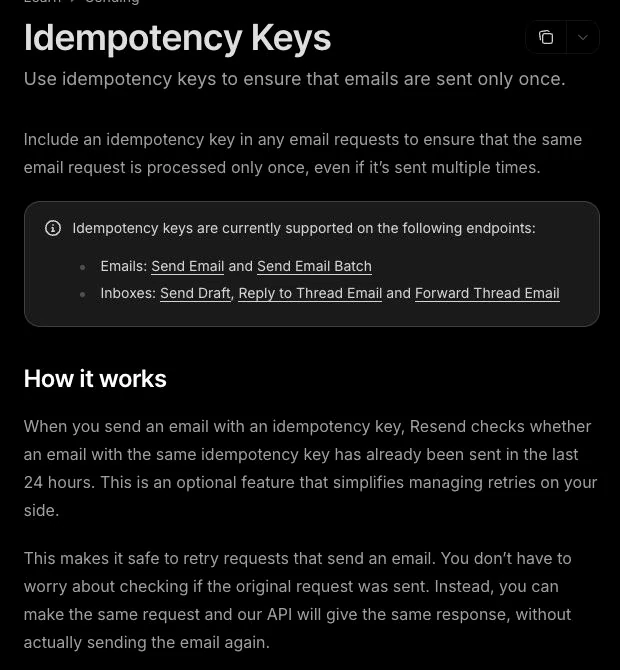
先做第一行,不把所有支持问题都交给一个可以自动承诺退款或改权限的机器人。配图里的Resend幂等说明针对的正是同一邮件请求重复到达这一类问题。
运行一次“发了却没记住”的故障
新建notification-demo.mjs,复制完整代码:
const job = { id: 'report-ready/demo-001', status: 'pending',
  attempts: 0, providerId: null };
const provider = new Map();
let loseFirstResponse = true;

async function mockSend(key) {
  if (!provider.has(key)) provider.set(key, 'mock-email-001');
  if (loseFirstResponse) {
    loseFirstResponse = false;
    throw new Error('response_lost_after_acceptance');
  }
  return provider.get(key);
}

async function run() {
  if (job.status === 'accepted') return;
  job.attempts++;
  try {
    job.providerId = await mockSend(job.id);
    job.status = 'accepted';
  } catch {
    job.status = job.attempts >= 3 ? 'needs_review' : 'retry';
  }
  console.log(job.status, job.attempts, provider.size);
}
await run();
await run();
await run();
console.log('provider messages:', provider.size);
执行node notification-demo.mjs,应得到:
retry 1 1
accepted 2 1
provider messages: 1
第一次模拟服务商已经接受并创建邮件,但响应丢失,本地记为retry。第二次使用相同key,服务商返回原消息;第三次发现本地accepted,不再发。最后的1表示只有一封模拟邮件。
把mockSend(job.id)故意改成mockSend(job.id + '/' + job.attempts),再运行,最终会变成2封。你能看到为什么重试时临时生成新键会破坏防重复。恢复原写法。
把内存任务放进PostgreSQL
上面的Map和job重启就消失。实际API在“保存报告”的同一数据库事务里插入通知任务,并给(report_id, notification_type)建立唯一约束。这样报告保存了,通知任务也有记录;同一报告的完成回调重复到达,不再新建第二个任务。
任务表最少保留这些已填示例字段:
id: report-ready/demo-001
report_id: demo-report-001
type: report_ready
status: pending
attempts: 0
next_attempt_at: 2026-11-02T09:00:00Z
provider_message_id: null
last_error_code: null
Node后台工作进程领取到期任务时,用数据库事务与行锁领取,并设置租约结束时间;多个进程不能同时把同一任务当成未领取。进程崩溃后租约到期可以再尝试,仍使用相同通知ID。邮件API调用不长时间占用数据库事务,调用后再将平台消息ID写回。
这一段是生产接法说明,不是声称本地Map已经有跨进程一致性。领取SQL与持久化代码要按你的现有PostgreSQL任务实现补齐,再做两工作进程竞争测试。
给失败分支一个落脚点
请求超时可以用相同幂等键重试;参数错误则先修配置,不每分钟重发。为练习选一个可解释的安排:第一次失败后1分钟、第二次5分钟、第三次转人工查看。这是本产品的示例安排,不是平台默认值。
Resend幂等键保留窗口为24小时。应用自己的发送记录保留更久,超过平台窗口后先查询已记录的消息与业务状态,不盲目发送。accepted仍不代表送达;明确退信后停发并提供修正邮箱入口。
如果以后改用队列,Cloudflare队列投递保证说明默认可能重复投递。这个事实支持继续保留任务ID和唯一记录,而不是让你为了发一封邮件就迁移整个Node/Railway系统。
工作流重试说明则展示等待和重试可分步骤管理。无论选择哪种调度方式,都让下一次尝试时间存下来,避免一条永久失败任务在循环中高速消耗费用。
留给人工的消息只带必要信息
第三次失败后,运营页面显示通知ID、报告ID、错误代码、尝试次数、下一动作即可,不把用户文案和邮件正文全部贴进告警。你在页面上修正配置、查询已有平台消息,再明确选择重试或结束。
记录本次运行的两行状态和最后的provider messages: 1。这份小程序已经演示一次常见故障如何恢复;迁到数据库后,目标仍是报告完成有任务、重试有原键、失败有可接手的位置。