技术扩容:性能、稳定性与基础设施成本
用户说“报告很慢”,你先要知道慢在哪里。本篇完成一份慢请求诊断与扩容草案,不把增加机器当成第一步。沿用Astro首页、Fastify API、PostgreSQL与Railway,Cloudflare文档只用来解释边缘运行与缓存,不要求换整套平台。
需要已有你有权查看的测试部署、请求日志和资源图;没有时,先用下列教学耗时表计算。所有延迟和负载数字为假设,作者没有对你的服务做压测。
从一条请求中拆出三段等待
假设一条文案检查共花12秒:
| 段落 | 已填教学耗时 | 可检查的东西 |
|---|---|---|
| 身份、额度与数据库准备 | 0.2秒 | 请求ID、数据库查询时间 |
| 外部模型等待 | 11.5秒 | 调用开始/结束、超时与重试 |
| 保存报告并返回 | 0.3秒 | 写入时间、响应体大小 |
| 总计 | 12.0秒 | 用户实际等到结果的时间 |
如果瓶颈是11.5秒模型等待,给API加CPU未必缩短这次模型调用。先观察模型端延迟、输出长度与重试,再考虑异步任务和让用户可恢复的等待页。
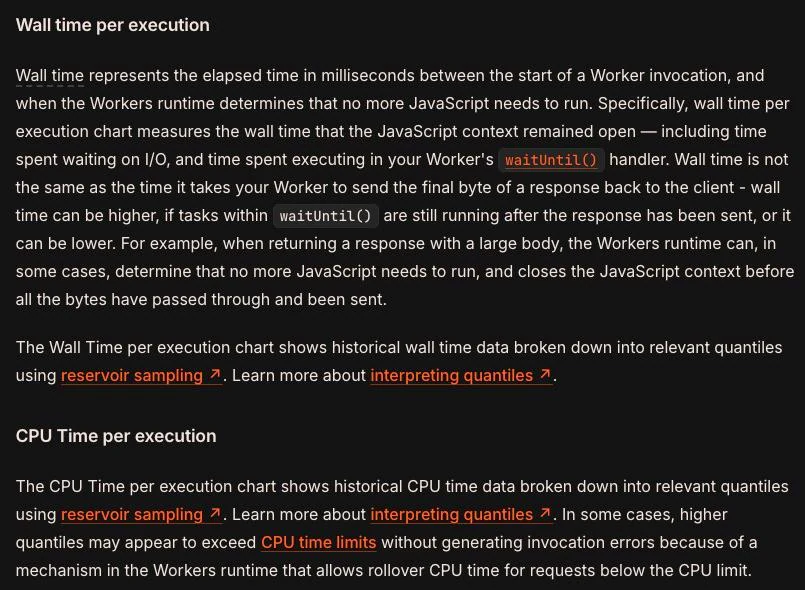
配图来自Cloudflare Workers限制说明,它把CPU执行时间和包含网络等待的总经过时间分开。这里借它区分两个概念,不把Workers的资源限额套用到Railway。平台不同,也都需要知道自己在算CPU、等待还是队列积压。
在Railway找到对应时间段
打开Railway资源指标说明,在项目画布选择API服务,再进 Metrics,把时间范围缩到慢报告发生的那几分钟。
- 查看CPU与内存是否接近实际服务限制,记下是否持续高位,而不只看某一个瞬时尖峰。
- 对照部署标记与应用日志,查是否新版本后突然变慢。
- 用同一个请求ID查模型调用和数据库查询耗时,不在日志中记录原始客户文案或密钥。
资源图不能替你告诉“报告成功率是多少”。Google SRE监控章节区分指标、结构化日志等用途;本例需要应用记录任务是否成功、排队多久、调用多久和最终耗时,才能和CPU图一起判断。
只读查看不改配置。若尚未有耗时字段,先在教学环境补上request_id、queue_ms、model_ms、db_ms、result这几项,再复现一次行李清单任务。
用一分钟的到达量算并发
假设高峰每分钟30个任务,每个平均占用12秒,平均在途量约为:
每秒到达量 = 30 / 60 = 0.5
平均在途任务 = 0.5 × 12 = 6
这个估算依赖相对稳定的到达和耗时,不是保证上限。一次社区发布可能十秒内挤来30个任务,还需要限流、排队和超时设计。先给服务端设置可控的并发任务数与用户额度预留,超过能力时显示排队,不让用户不断点击产生多个收费任务。
假设你准备将两个API副本各配置最大10个数据库连接,理论应用连接上限就是20,另有迁移、后台任务和管理连接需要留空间。副本增到4个时上限变40;数据库没跟着承受住,API副本越多反而可能越慢。
写一份只改一个变量的扩容草案
Railway扩容说明介绍在服务设置中增加副本及流量分配。执行前先确保登录会话、订单、任务状态都在共享数据库或适当共享存储;5-4的内存余额演示不能直接跑在两个副本上。
本例可复制草案如下,实际使用时替换测得数字:
触发问题:测试高峰API持续资源接近限制,排队明显增长
拟改动:独立测试环境从1个副本到2个,不同时改模型与数据库
保持:同一代码版本、输入集、模型参数、任务总数
观察:最终成功、排队p95、总耗时p95、数据库连接与小时费用
停止条件:出现重复发放、私有报告串用户、连接超限或费用失控
回退:将测试副本恢复1个,保留日志与未完成任务记录
如果测得资源很低、模型等待占大头,草案结论可以是“先不加副本,改异步任务与模型请求”。不要把这份草案当成已经执行的性能提升。
用缓存改善公开页面,不共享客户报告
Cloudflare缓存说明解释public、private与no-store。ClearCopy公开样例图片可以缓存,用户报告与额度接口则使用适合私有数据的响应策略,并在CDN规则中排除,不能靠忽略Cookie的全站缓存加速。
对一份私有报告,先在测试账号A读取,再以B尝试同一个地址。B应被拒绝且拿不到A正文;未登录也不能得到缓存副本。加Vary不是所有CDN默认会遵守的隔离方案,要实查所用平台规则。性能优化结束后还要重做这个读取测试。
最终保存一条12秒耗时拆分、一份6个平均在途任务的计算,以及“扩容/暂不扩容”的草案。你现在能说明钱准备花在哪段瓶颈上,而不只是给服务器套餐换一个更大的名字。